AI study
1. LangChain
LangChain是一个快速构建LLM代理和应用的方法,他提供与构建的代理架构和模型集成,只需要输入api就可集成LLM。
1.1 LangChain核心功能
| 模块类别 | 示例功能 |
|---|---|
| 模块接口封装 | OpenAI、Claude、Cohere、Qwen 等模型统一调用方式 |
| 输出结构化 | 自动从模型中解析 JSON、Schema、函数签名、文档等 |
| Memory管理 | Buffer、Summary、Entity、Conversation Memory 等 |
| Tool 接入 | Web 搜索、SQL 数据库、Python 执行器、API 代理等 |
| Agent 架构 | ReAct、Self-Ask、OpenAI Function Agent 等调度机制 |
| RAG继承 | 多种 Retriever、Vector Store、文档拆分策略 |
| Server/API 发布 | 快速将链部署为 Web 服务或 A2A Agent |
| Debug & Callback | Token 使用统计、LangSmith 可视化追踪等 |
可以说LangChain不仅仅是智能体开发应用的简单框架,更是模型应用组装的工具箱。
1.2 LangChain核心架构
LangChain核心架构大致分为三层
最底层的大模型API抽象层:内置开源模型调度框架封装API;中转&聚合平台封装API;其他自定义第三方模型封装API
中间层的工作流API抽象层:在确保模型接入后,LangChain有定义了一整套LCEL(LangChain Expression Language)语法,以方便开发者能够非常便捷的将提示词模板、大模型以及一些外部工具进行组合拼装,搭建一些工作流
最顶层的AGENT API抽象层:封装LangChain Agent基础封装逻辑,创建方法和编排方法。内置工具组调用方法等
2.LangGraph
LangChain和LangGraph是并列存在的,底层架构同源,接口完全相同,区别在于LangChain是链式结构而LangGraph是图装结构
3.NLP
NLP(Nation Language Processing),自然语言处理,是计算机科学,人工智能和语言学的交叉领域,研究如何让计算机处理、理解、生成人类语言。
NLP发展历程可大致分为四个阶段:
- 早期研究,侧重于人工写的规则和语法,如基于规则的方法
- 统计方法:引入数学和溶剂方法,侧重于从大规模语料库中自动学习语言规律,如隐马尔可夫模型(HMM),条件随机场(CRF)
- 深度学习:基于审计网络,强调自动提取和端到端的训练,如循环神经网络(RNN),长短时记忆网络(LSTM)等
- 预训练模型:基于大规模数据和深度学习模型的与训练方法,提升了NLP任务的性能,如GPT,BERT,T5
从上述发展历程中可以直观地看出,NLP模型发展趋势是参数量和通用性的双重提升
基于神经网络的方法
代表性又RNN循环神经网络和LSTM长短时记忆网络
时序网络模型
RNN(循环神经网络)
是按时间序列的前馈神经网络模型
训练后可处理书讯数据输入,并将其转换为特定的顺序数据输出;
问题:
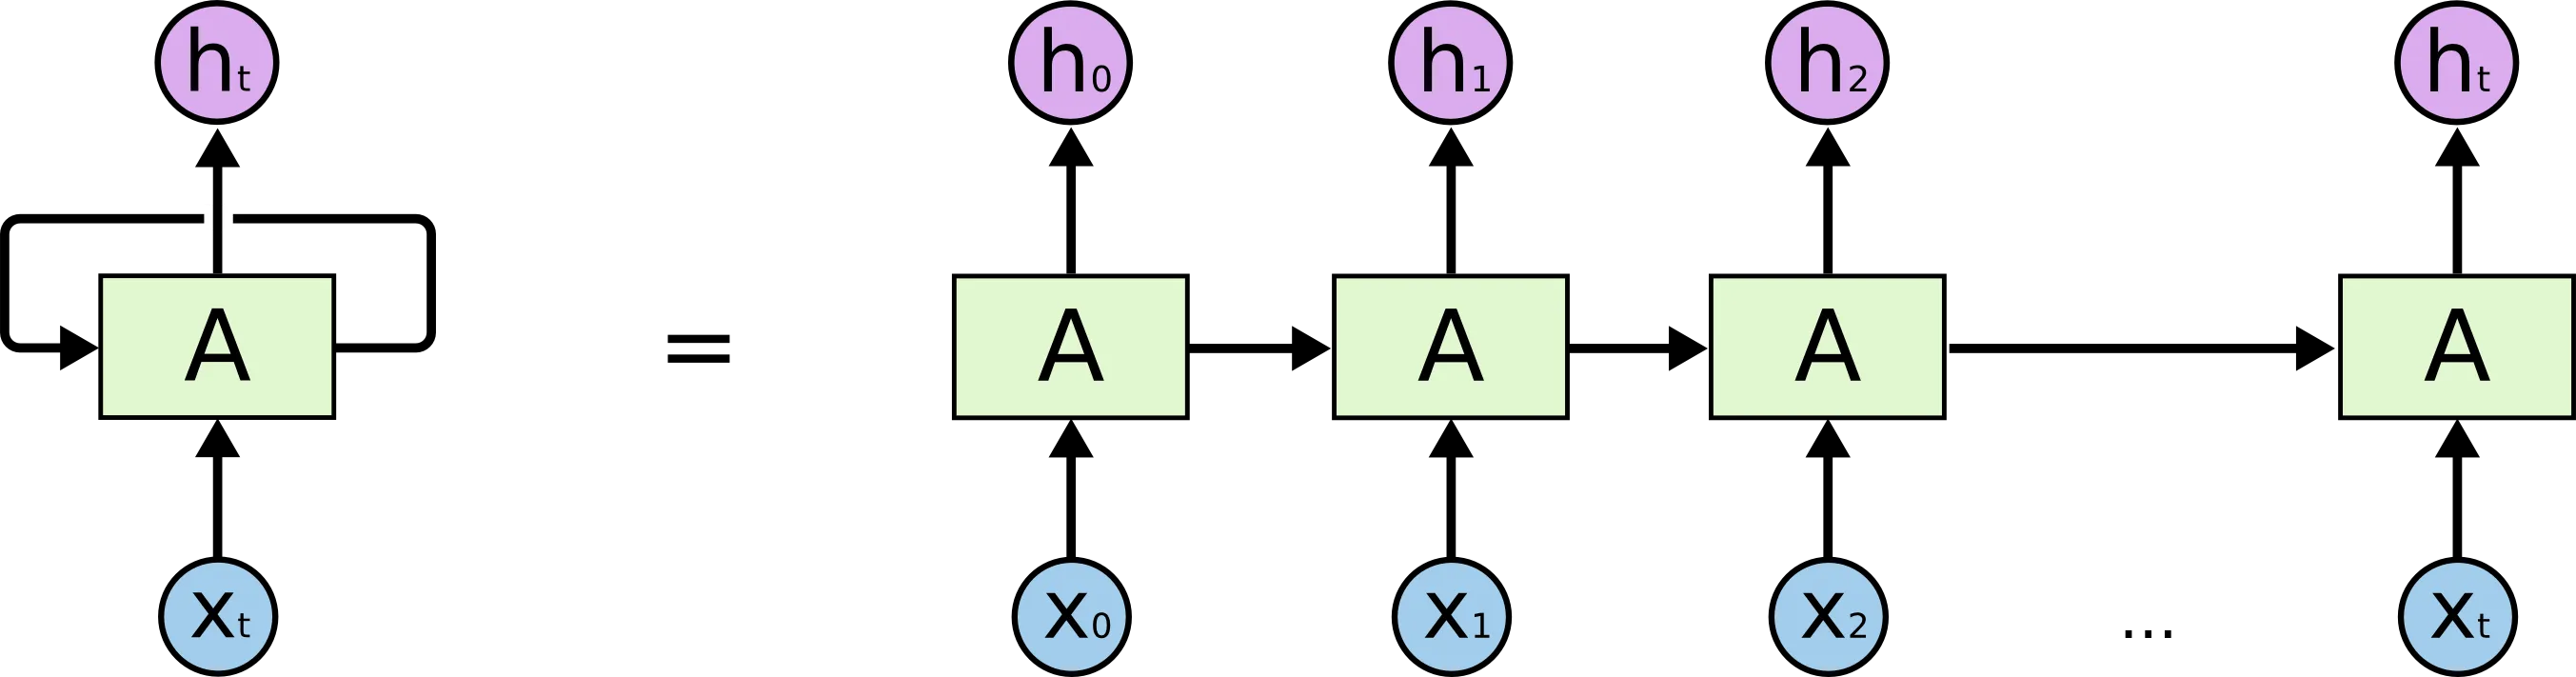
- 训练速度慢:时间序列处理
- 记忆时间短:记住后面的Token,容易忘记前面的
- 梯度消失或者梯度爆炸
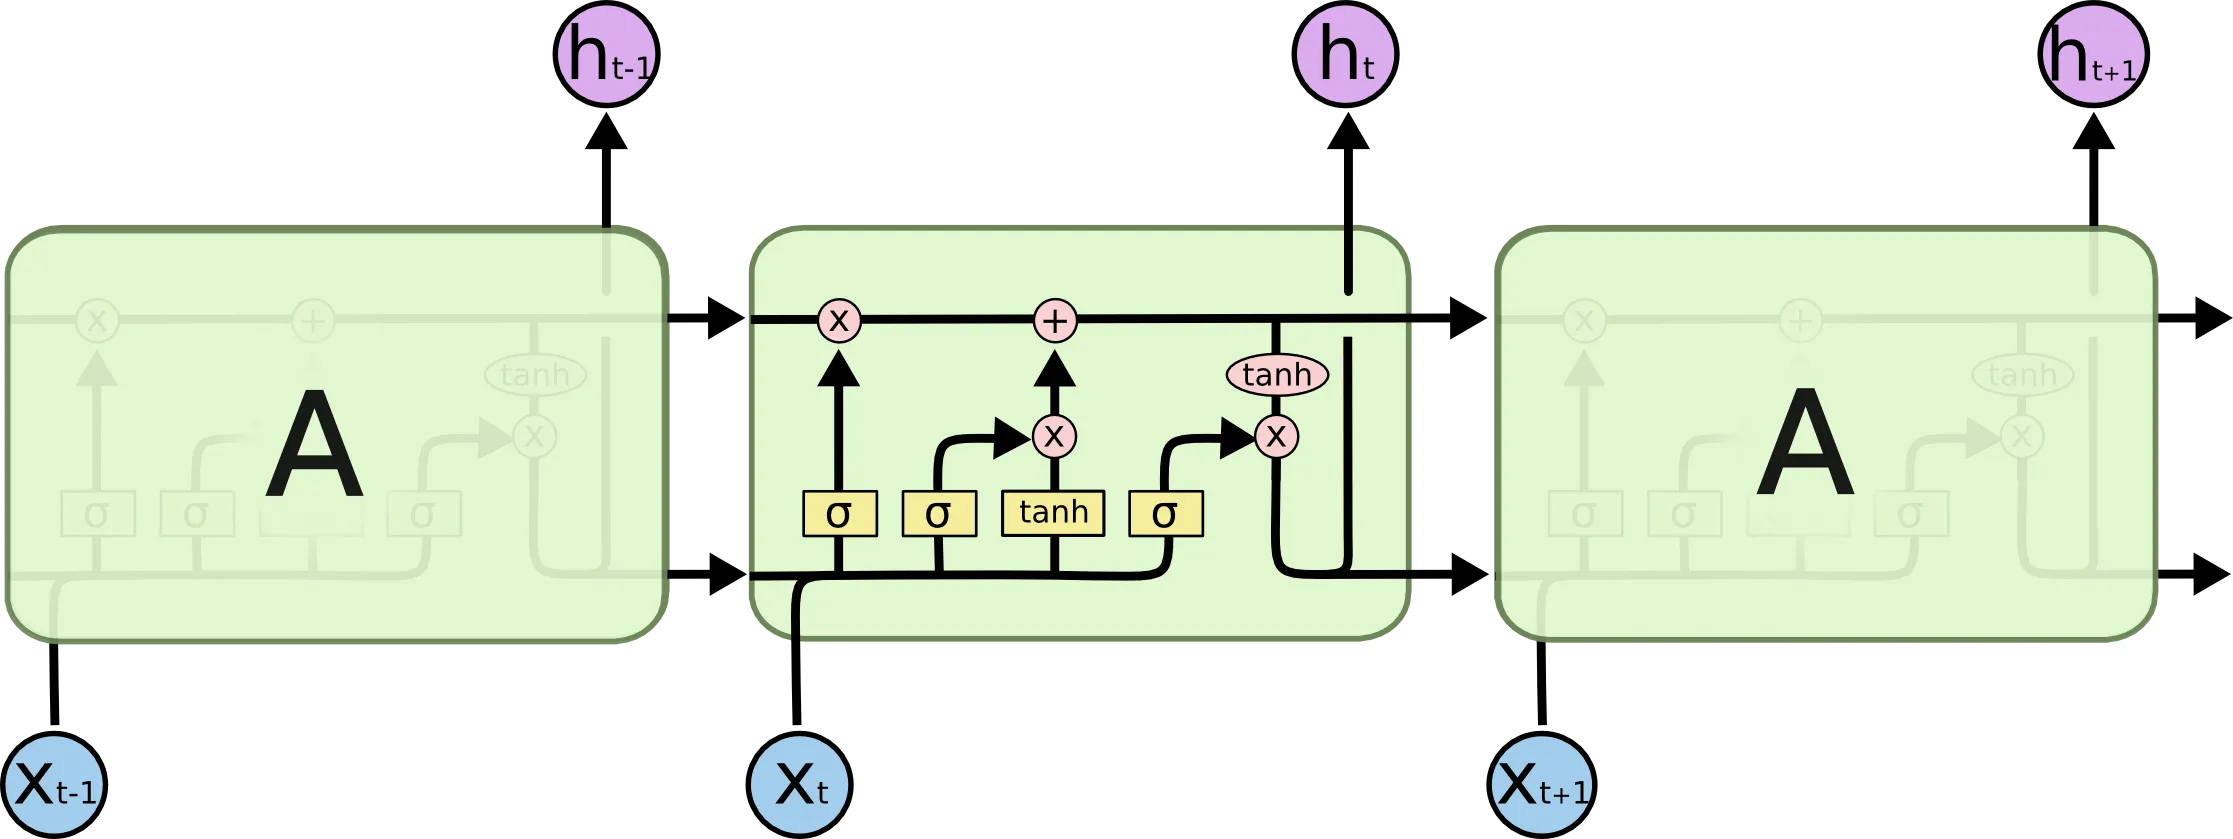
LSTM(Long Short-Term Memory)
是一种特殊的RNN网络,主要是为了环节RNN在处理上序列训练时的梯度消失或者梯度爆炸
加入了Forget Gate,Input Gate,Output Gate;
问题:
- 训练速度更慢
- 短期记忆和梯度问题未完全解决
Encoder-Decoder结构模型
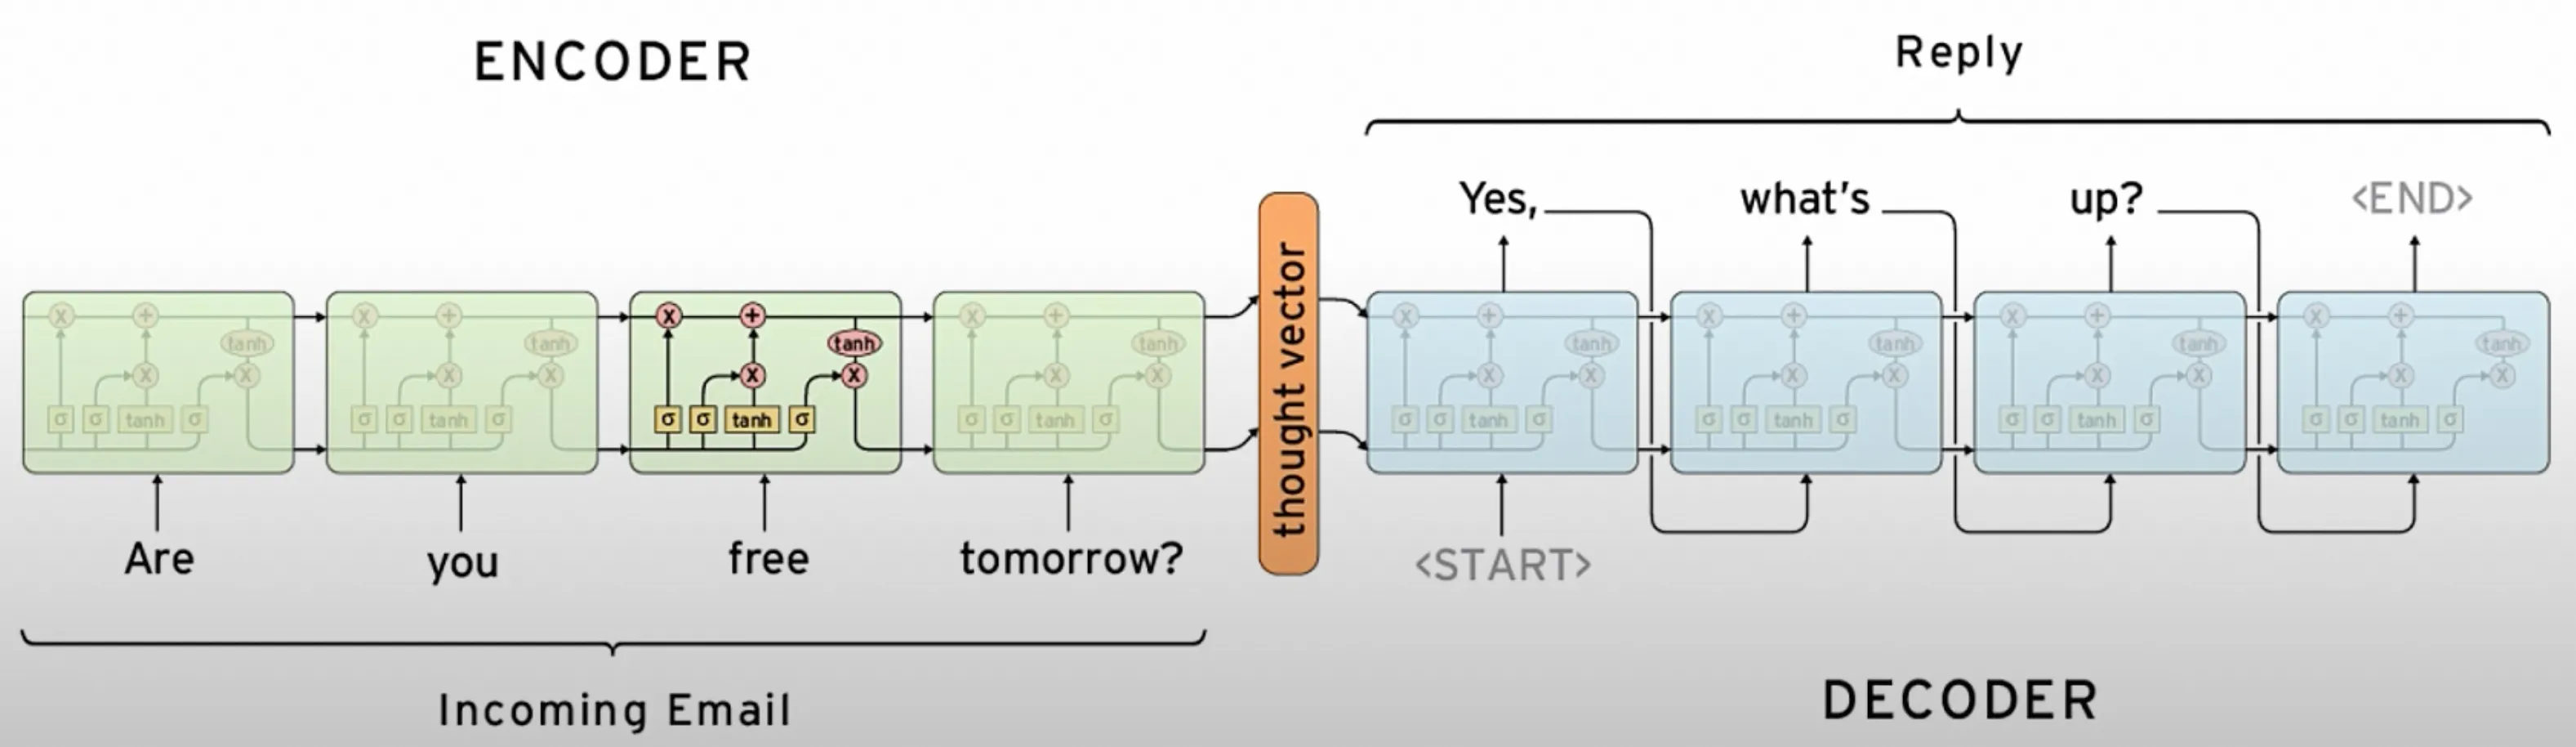
Seq to Seq(序列到序列)是一种特殊的数列建模问题,主要包括编码器和解码器,Encoder将输入序列进行处理,得到向量,向量输入到Decoder转化成想要的输出
Transformer
Transformer架构为左边Encoder右边Decoder结构,如下图所示
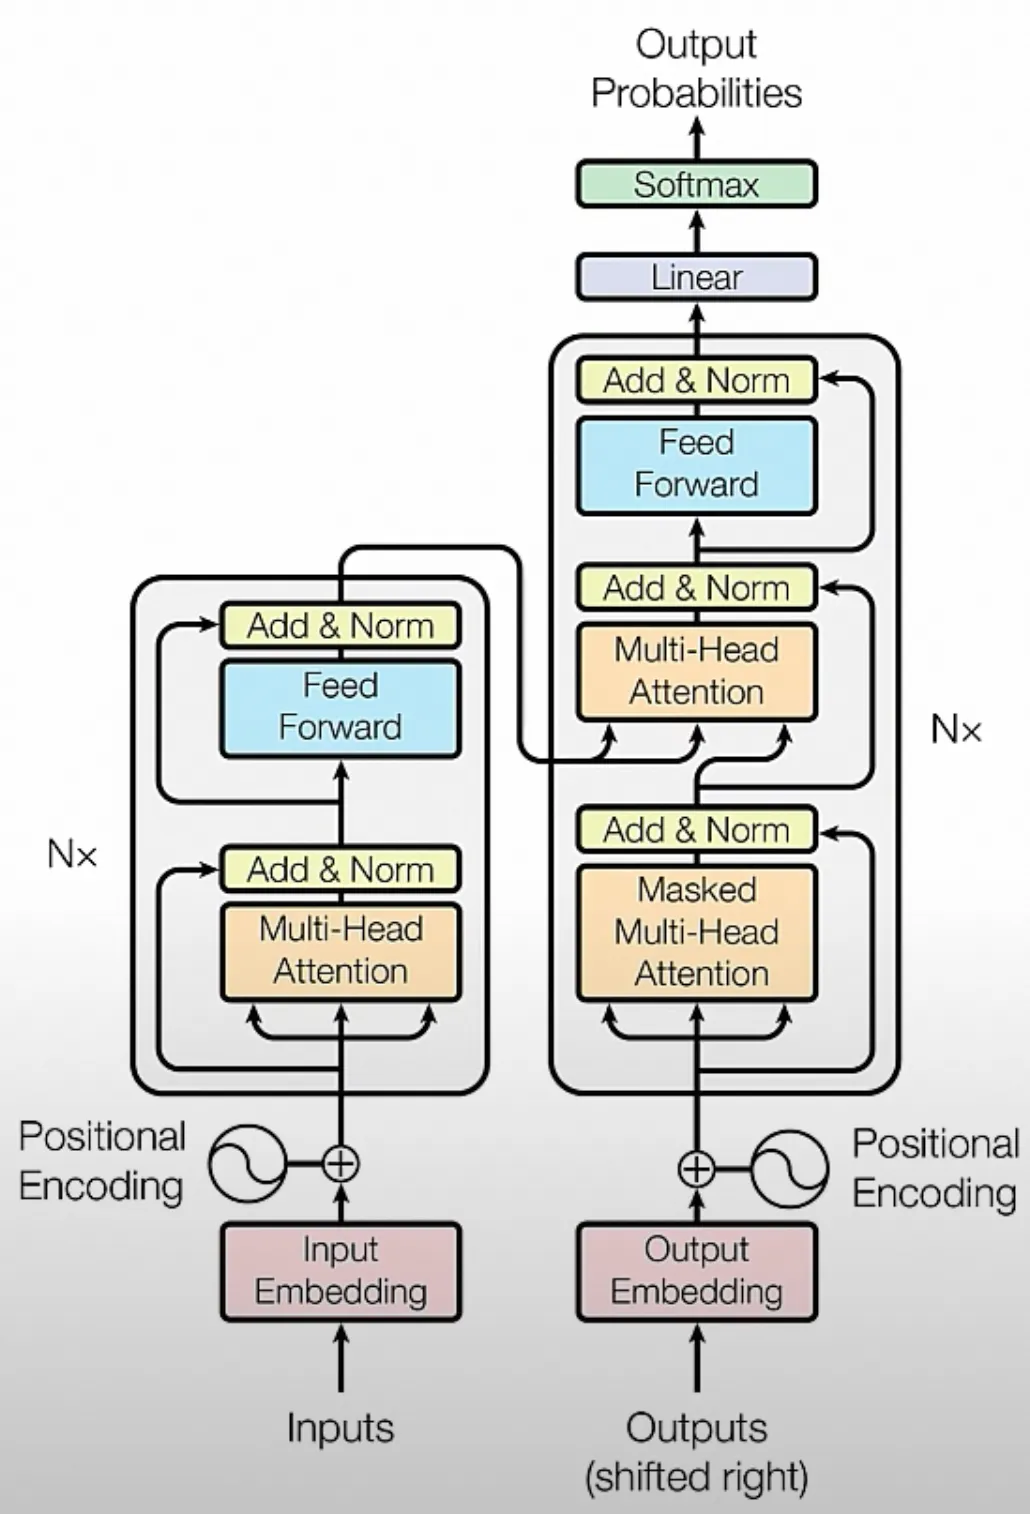
从网络结构角度来看,Transformer中Encoder与Decoder的主要区别在于Self-Attention机制的Mask应用。具体而言,Encoder在计算Self-Attention时不使用Mask,而Decoder则引入了Mask操作。
从训练和预测过程来看,训练阶段Encoder和Decoder均可并行计算;但在预测阶段,仅Encoder支持并行计算,Decoder则需顺序处理。
Self Attention
Self attention最重要的组成部分是QKV三个向量
Query:查询当前单词表示用于与其他所有单词进行评分
Key:关键向量就像是单中所有单词的标签
Value:值向量是实际的单词表示,一旦堆某个单词进行评分,这些数值就会相加表示当前的单词。
在Attention模块中的,对当前Q和所有的K计算相似度,然后通过Softmax操作得到权重,最后根据权重与对应的V成绩求和,得到Attention的Value值。
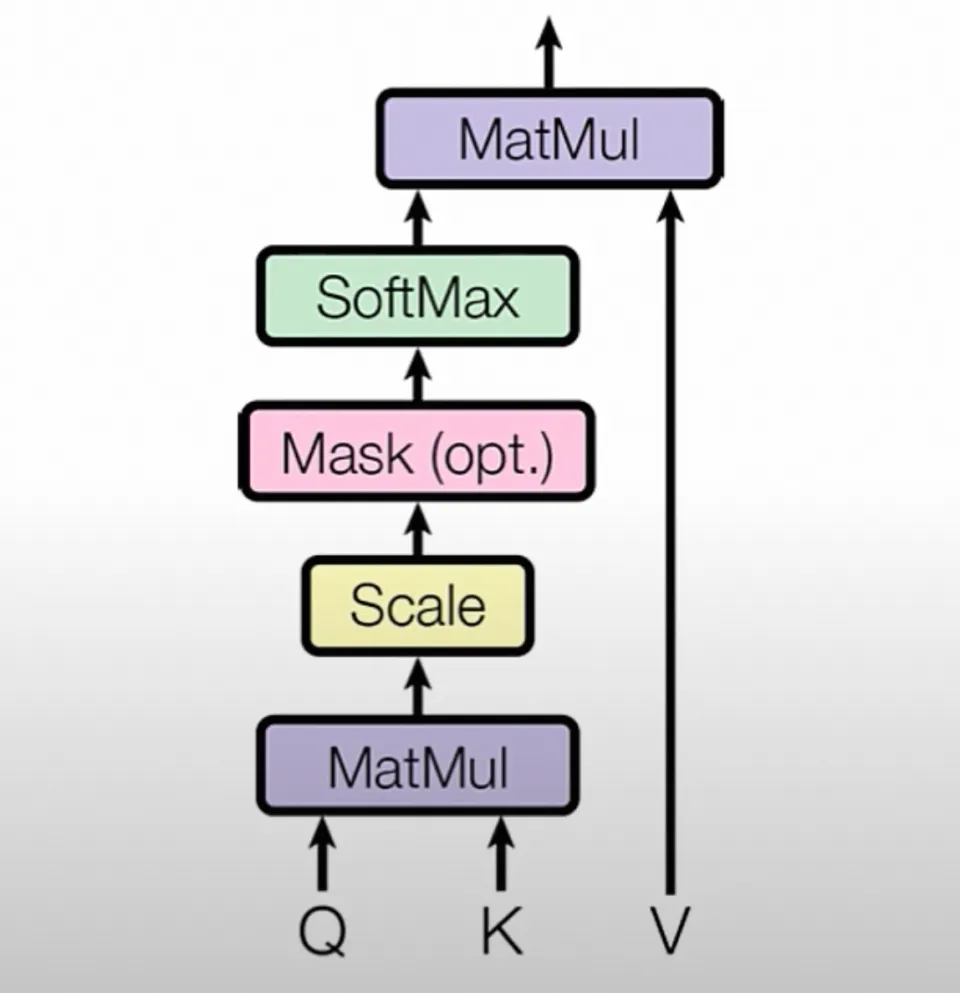
因此,在Attention中的Scaled dot-product attention运算为
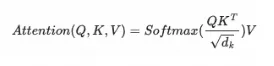
简单来说就像是在图书馆取书,Query查询含有目标tag的书架,Key就是每个书架上贴的tag,Value就是里面书的内容,不过在实际应用中往往不是单一数值。而是多个不同信息的组合。
通过将Q向量与每一个K向量相乘(点积运算后加上Softmax运算),可以为每个文件计算出来一个得分。
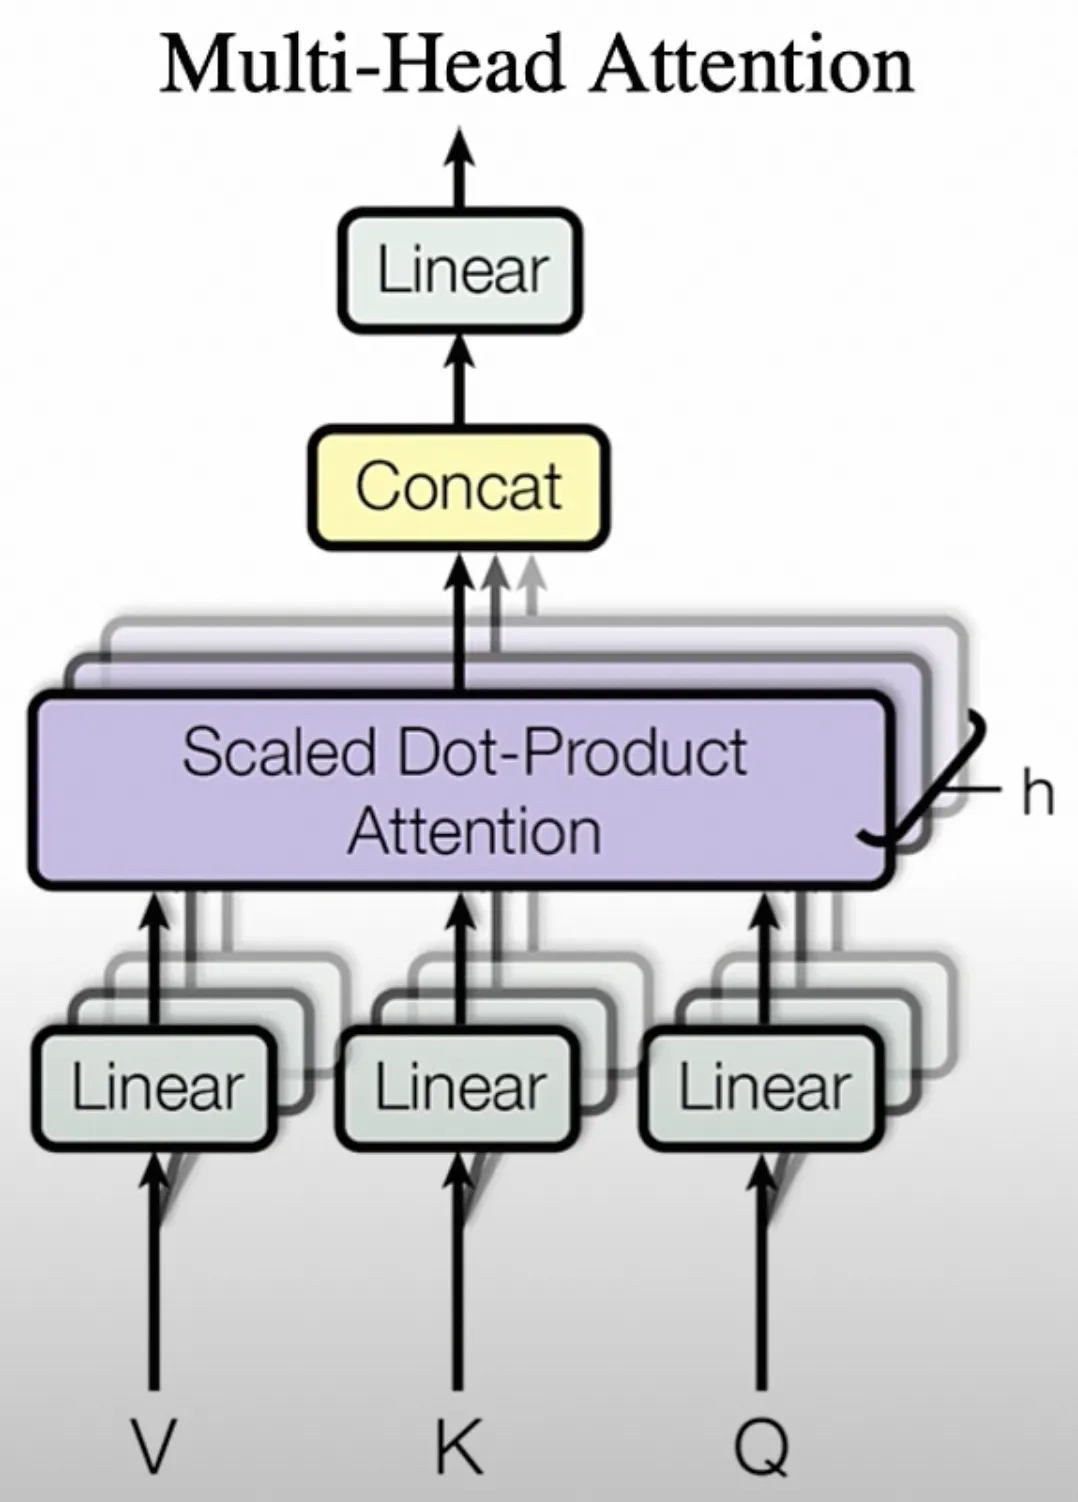
Multi-head attention
多头注意力机制是进行多个Self-Attention的结合,每个head都会学到不同表示空间中的特征
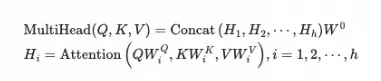
其他网络结构
Norm:对数据归一化,将数据约束到高斯分布上,稳定训练;
Add&Residual:残差相加,避免梯度消失,构建更深的网络;
Feed Forward:将数据转化为非线性,更好表征复杂关系;
Masked Multi Head Attention:在Decoder中,将MHA中的矩阵与右上角进行掩码的矩阵相乘,其他操作与MHA相同;
Softmax:在模型的Decoder之后进行归一化,得到概率输出。
未完待续